Thiết kế hệ thống batch insert dữ liệu lớn mà không chặn truy vấn
Bốn hướng thiết kế database cho bài toán ghi batch định kỳ lượng lớn không có key để update — Delta Processing, A/B Table Swapping, Table Versioning, và cách kết hợp có history.
Bối cảnh
Bài toán: thiết kế hệ thống batch insert (ghi theo lô) định kỳ với lượng dữ liệu lớn, không phụ thuộc vào key, mà không gây ảnh hưởng tới truy vấn đang diễn ra liên tục.
Hai phần cần giải:
- Batch processing dữ liệu đầu vào — gom, chuẩn hoá, ghi.
- Thiết kế database để lưu và truy vấn được dữ liệu mới nhất.
Có bốn hướng thiết kế database chính, bài này đi qua cả bốn:
- Delta Style Processing (Staging + Hash Join)
- A/B Swapping Table Architecture
- Table Versioning
- Kết hợp Delta Processing + A/B Table Swapping, thêm history table
Năm vấn đề phải giải
Vấn đề 1 — Không có key để update. Không dùng được ON DUPLICATE KEY UPDATE hay UPSERT.
Vấn đề 2 — Tránh mất dữ liệu khi ghi batch. Cần cơ chế transactional.
Vấn đề 3 — Phục vụ truy vấn real-time. Truy vấn phải rõ ràng, chỉ lấy đúng dữ liệu mới nhất.
Vấn đề 4 — Chuẩn hoá đầu vào từ nhiều nguồn. Cần batch xử lý, gom dữ liệu và ghi lại thành cấu trúc chuẩn.
Vấn đề 5 — DDL command không hoạt động trong transaction. Cần cân nhắc cách xử lý các câu lệnh DDL (DROP, RENAME, LOCK…) sao cho vẫn đảm bảo atomic và isolation.
Vấn đề 5 là cái bẫy khó thấy nhất, và nó ảnh hưởng trực tiếp tới việc chọn phương án nào ở phần sau.
Batch Processing Input Data
Batch process gom dữ liệu vào một tiến trình xử lý, chuẩn hoá, sau đó ghi vào database. Nếu batch fail giữa chừng thì phải rollback toàn bộ transaction.
Pros
- Xử lý hiệu quả với dữ liệu lớn.
- Ít ảnh hưởng đến hệ thống đang chạy.
- Có thể phân tích log và retry khi thất bại.
Cons
- Delay tự nhiên theo batch window (độ trễ do chu kỳ chạy).
- Phải kiểm tra lỗi batch rõ ràng.
- Tăng độ phức tạp nếu các batch phụ thuộc vào nhau.
Tính ACID cần đảm bảo
| Thuộc tính | Yêu cầu cụ thể |
|---|---|
| Atomicity | Insert tất cả hoặc không insert gì cả. Lỗi giữa chừng thì rollback toàn bộ. |
| Consistency | Sau mỗi batch, dữ liệu phải ở trạng thái hợp lệ. |
| Isolation | Truy vấn không bị ảnh hưởng trong lúc đang ghi batch — nếu dùng table switching hoặc versioning. |
| Durability | Khi commit xong, dữ liệu phải tồn tại bền vững. |
Phương án 1 — Delta Style Processing (Staging + Hash Join)
Có hai bảng: main_table và staging_table. Mỗi record mang một hash/checksum để so sánh.
Flow
- Load dữ liệu mới vào
staging_table. - So sánh hash giữa
main_tablevàstaging_tablebằngLEFT JOIN. DELETEcác record chỉ có ởmain_table.INSERTcác record mới vàomain_table.
Pros
- Luôn chỉ có một bảng dữ liệu chính.
- Dùng được trong hệ thống hiện tại mà không phải thay đổi nhiều.
Cons
- JOIN hash tốn performance nếu lượng dữ liệu lớn.
- Không transactional nếu dùng
DELETE+INSERTriêng rẽ. - Không lưu lại lịch sử thay đổi mỗi lần batch insert.
ACID
Nếu không bọc DELETE + INSERT trong một transaction lớn, rất dễ rơi vào trạng thái inconsistent khi batch lỗi giữa chừng.
Phương án 2 — A/B Table Swapping
Có hai bảng table_A và table_B thay phiên nhau nhận dữ liệu. Có hai cách triển khai.
Cách 1 — Dùng biến table_master để xác định bảng đang active
- Có bảng
table_masterlưu trạng thái đang dùng là A hay B. - Truy vấn đọc theo trạng thái trong
table_master. - Khi ghi batch mới:
- Ghi vào bảng còn lại (ví dụ
B). - Ghi xong thì update
table_masterthànhB. - Truncate bảng
A.
- Ghi vào bảng còn lại (ví dụ
Cách 2 — Dùng View tham chiếu đúng bảng
CREATE OR REPLACE VIEW data_view AS
SELECT * FROM table_A WHERE EXISTS (SELECT 1 FROM table_A)
UNION ALL
SELECT * FROM table_B WHERE NOT EXISTS (SELECT 1 FROM table_A);
Cách này khá hay nên đáng giải thích kỹ: view tự chọn bảng dựa vào bảng nào đang có dữ liệu. Nếu table_A có record thì nhánh đầu trả về dữ liệu của A và nhánh sau bị loại; nếu table_A rỗng thì ngược lại. Không cần bảng metadata nào, trạng thái nằm ngay trong chính dữ liệu.
Khi ghi xong batch, truncate bảng còn lại rồi commit transaction.
Pros
- Không ảnh hưởng đến data đang được query.
- Không cần JOIN hash,
INSERTtrực tiếp. - Truy vấn nhanh khi dùng view, vì index của bảng gốc được giữ nguyên.
Cons
- Dữ liệu gấp đôi (A + B).
- Nhiều bảng nếu có nhiều dataset.
- Cần đảm bảo update view/pointer đúng thứ tự — ghi xong mới update.
- Không lưu lại lịch sử thay đổi mỗi lần batch insert.
ACID
Phải commit transaction sau khi ghi xong rồi mới swap view hoặc update pointer. Nếu fail trước khi swap thì hệ thống vẫn dùng bảng cũ, hoàn toàn không ảnh hưởng — đây là tính chất đáng giá nhất của phương án này.
Phương án 3 — Table Versioning
- Một bảng metadata chứa record
versionvới value là số tăng dần. - Bảng chính có thêm field
version, truy vấn dùng:
SELECT * FROM main_table
WHERE version = (SELECT value FROM METADATA WHERE name = 'version');- Có thể partition theo
dateđể tăng tốc query và dễ cleanup.
Flow
- Ghi batch mới với
versiontăng dần. - Query dùng subquery để lấy version hiện hành.
- Xoá version cũ định kỳ.
Pros
- Truy vấn theo version linh hoạt.
- Lưu được nhiều version nếu cần rollback hoặc debug.
Cons
- Cần index + partition để đảm bảo hiệu năng.
- Dữ liệu nhanh bị phình.
- Cần định kỳ chạy
OPTIMIZE TABLEsau mỗi lần xoá data cũ.
ACID
Insert batch theo version mới phải hoàn tất thì truy vấn mới thấy. Nếu batch chưa ghi xong, version vẫn trỏ về version cũ.
Phương án 4 — Delta Processing + A/B Swapping + History table
Thêm một bảng history để lưu các lần thay đổi.
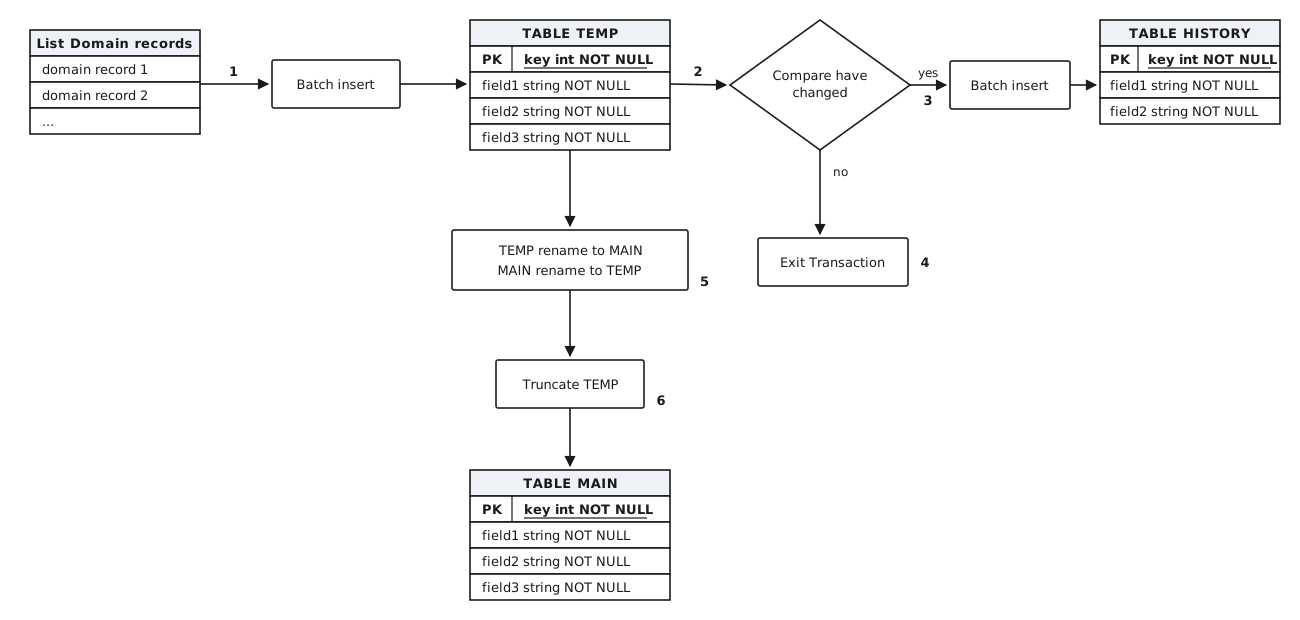
Flow
- Tạo table tạm với cấu trúc lấy từ table
Domain_info. - Batch insert vào table tạm.
- Compare data giữa table tạm và table
Domain_info. - Nếu có khác thì insert từ table tạm vào table history.
- Rename table tạm thành
Domain_info, vàDomain_infothành table tạm. - Sau khi commit transaction thì drop table tạm.
Pros
- Không ảnh hưởng đến data đang query.
- Lưu history update dễ dàng.
- Dữ liệu không bị phình như phương án versioning.
Cons
- Cần index + partition để đảm bảo hiệu năng.
ACID
Insert batch data mới và rename table phải hoàn tất thì truy vấn mới thấy. Nếu batch chưa ghi xong, query vẫn chạy trên data cũ và không bị ảnh hưởng.
So sánh bốn phương án
| Delta + Hash Join | A/B Swapping | Versioning | Delta + A/B + History | |
|---|---|---|---|---|
| Ảnh hưởng truy vấn khi ghi | có | không | không | không |
| Lưu lịch sử thay đổi | không | không | có | có |
| Dữ liệu phình | không | gấp đôi | nhanh phình | không |
| Chi phí performance | JOIN hash tốn | thấp | cần index + partition | cần index + partition |
| Số bảng phải quản lý | 2 | 2 mỗi dataset | 2 | 3 |
Quy chuẩn khi triển khai
- View phải dùng
WITH CHECK OPTIONnếu có insert qua view. - Khi truncate hoặc drop bảng, đảm bảo không có query đồng thời.
- Tất cả insert phải transactional nếu liên quan nhiều bảng.
- Batch input phải có log, retry, và kiểm soát size.
- Nếu batch lỗi giữa chừng thì không swap view hoặc pointer, rollback lại hết.
- Dọn dẹp bảng cũ sau khi đã xác minh batch mới hoạt động đúng.
Hai lưu ý quan trọng
DDL không rollback được trong transaction. CREATE, RENAME và DROP TABLE là DDL statement — trong MySQL chúng gây implicit commit: transaction đang mở sẽ bị commit rồi DDL mới chạy. Nghĩa là không thể trông vào rollback để hoàn tác chúng.
Điều này đúng với MySQL. Một số DBMS khác như PostgreSQL và Oracle có hỗ trợ transactional DDL, cho phép ALTER/CREATE nằm trong transaction. Nên nếu bạn thiết kế theo phương án 4 (dựa vào RENAME), hãy kiểm tra kỹ DBMS đang dùng — đây chính là Vấn đề 5 ở đầu bài.
Tuning cho batch lớn. Nếu cần tăng performance thêm, cân nhắc tăng innodb_buffer_pool_size và innodb_log_file_size trong cấu hình instance MySQL.